DeepSeek-V4.1-Flash:KV キャッシュを 890 バイト/トークンに圧縮し 100 万トークン長文脈を効率化するマルチモーダル MoE
552B パラメータを持つマルチモーダル MoE モデル DeepSeek-V4.1-Flash は、CED アーキテクチャと CSA2・FP4 圧縮の組み合わせにより、グローバル KV キャッシュフットプリントを既存モデル比で 1/4 に削減しつつ強力な性能を実現した。
リリース: 2026-09-17 · 読了 5 分論文概要
DeepSeek-AIが発表した「DeepSeek-V4.1-Flash」は、長文脈エージェント用途における入力負荷とKVキャッシュのボトルネックを解決するために設計された、総パラメータ数552BのマルチモーダルMixture-of-Experts (MoE) モデルである。最大100万トークンのコンテキストをサポートし、Causal Encoder-Decoder (CED) アーキテクチャの採用により、デコード時には1トークンあたり16Bのパラメータを活性化する一方、プリフィル(事前処理)時には8Bのみを活性化することで高いコスト効率を達成している。さらに、Compressed Sparse Attention 2 (CSA2) のクロスレイヤKVキャッシュ再利用とFP4 KVキャッシングを組み合わせることで、グローバルKVキャッシュフットプリント(常にHBMに常駐)を1トークンあたり890バイトに削減し、これはDeepSeek-V4-Flashの約1/4に相当する。 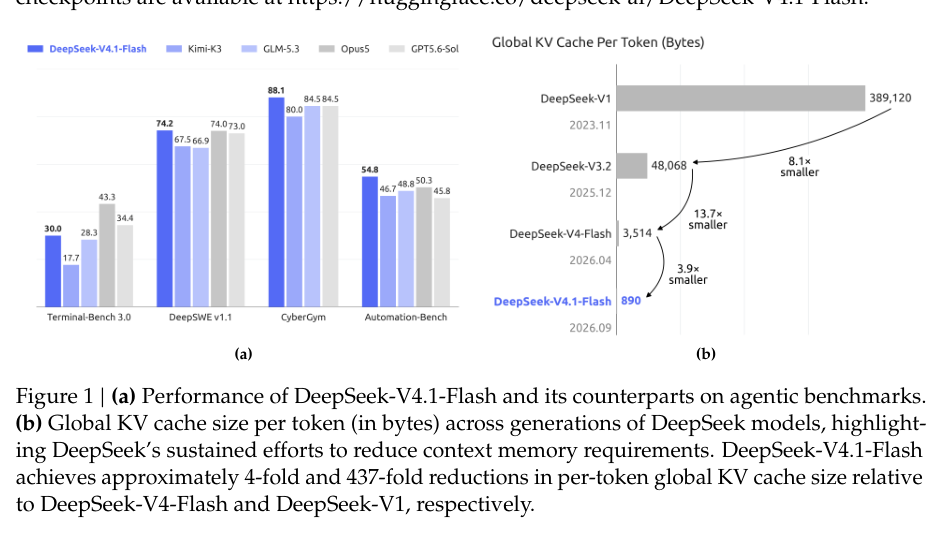
関連研究
従来の大規模言語モデルでは、長文脈化やエージェントの自律動作に伴ってプレフィルの計算コストやHBM・SSDのストレージ容量、データ転送帯域が深刻なボトルネックとなっていた。これに対し、既存の長文脈モデルやKVキャッシュ圧縮手法は計算コストやメモリ帯域をある程度削減したものの、膨大なキャッシュ容量の削減とモデル性能の維持を両立する点で限界があった。本研究は、CEDアーキテクチャやFP4圧縮、CSA2のクロスレイヤ再利用を統合することで、このトレードオフを大幅に打破している。
新規性と貢献
本研究の主要な貢献は、以下の3点に集約される。
- デコード時とプリフィル時で活性化パラメータ数を非対称にするCEDアーキテクチャの導入。
- CSA2におけるクロスレイヤKVキャッシュ再利用とFP4量子化を組み合わせた、1トークンあたり890バイトという極小のグローバルKVキャッシュフットプリントの実現。
- SWA Bounded Replay最適化による、SSDやホストメモリ上の永続的KVキャッシュの約1/8(DeepSeek-V4-Flash比)への縮小。
提案手法の詳細
DeepSeek-V4.1-Flashの基盤となるのは、40層のネットワーク構造を持つCEDアーキテクチャである。 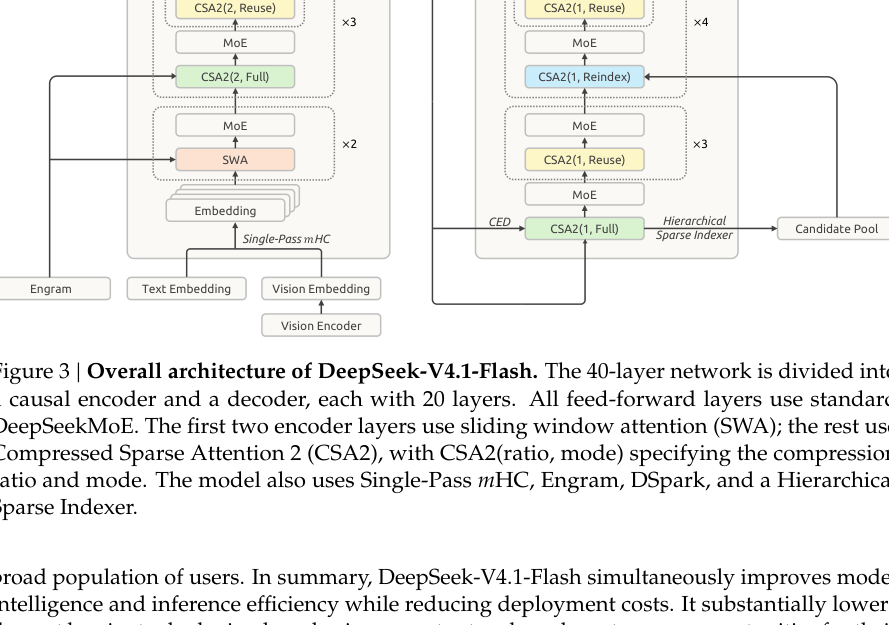 プリフィル時の計算量を抑えつつデコード性能を確保するため、デコード時に16B、プリフィル時に8Bのパラメータを動的に切り替える設計を採用している。また、KVキャッシュの圧縮においては、CSA2によるクロスレイヤでのキャッシュ再利用とFP4精度の量子化を組み合わせることで、情報ロスを最小限に抑えながらメモリ使用量を劇的に圧縮している。
評価・考察
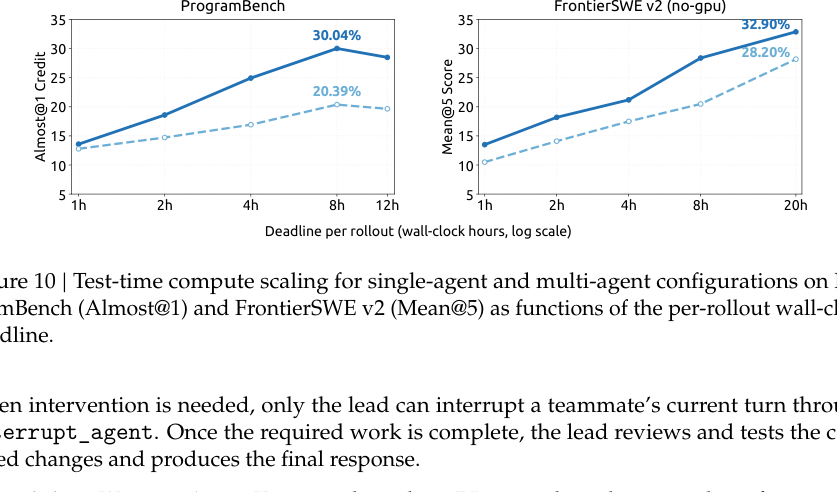
45兆トークンのマルチモーダルコーパスによる事前学習と包括的なポストトレーニングを経て評価された結果、DeepSeek-V4.1-Flashは、KVキャッシュ容量を大幅に削減しているにもかかわらず、ベースラインモデルを大きく上回る強力な性能を多様なテキスト・マルチモーダルエージェントシナリオで実証している。
応用例と今後の展望
実務的なインパクトとして、金融業界や法務分野における100万トークン規模の長大文書解析、および複雑なマルチステップのソフトウェアエンジニアリングエージェントシステム(数千〜数万リクエスト/日の規模)において、HBMのメモリプレッシャーを激減させ、APIのホスティングコストを大幅に引き下げることが可能となる。今後の課題としては、超長文脈における微小な精度劣化のさらなる抑制と、多様なハードウェアアクセラレータ上でのFP4演算の最適化が挙げられる。
結論
DeepSeek-V4.1-Flashは、CED構造と先進的なKVキャッシュ圧縮技術(CSA2・FP4)を融合させることで、100万トークン長のマルチモーダル処理におけるメモリと帯域のボトルネックを効果的に解消し、次世代の高効率エージェント基盤としての優れた実用性を示した。
注釈
- KV Cache: Transformerモデルの自己注意機構(Self-Attention)において、過去のトークンのKeyとValueを保持し、生成時の再計算を防ぐためのメモリ領域。
- MoE (Mixture-of-Experts): 入力ごとに適切な少数のエキスパートネットワークを選択して処理を行うことで、全パラメータを動かさずに大規模化と高効率化を両立するアーキテクチャ。