臨床動画の感情認識向け Modality Discrepancy Transformer──クロスモーダル不一致を捉える 9 トークン表現で既存比 10pt 超の精度向上を達成
顔・音声・言語の矛盾シグナルを検出する Modality Discrepancy Transformer を提案し、BAH データセットのテストスプリットで Macro F1 0.7408 を記録した。
リリース: 2026-07-18 · 読了 5 分論文概要
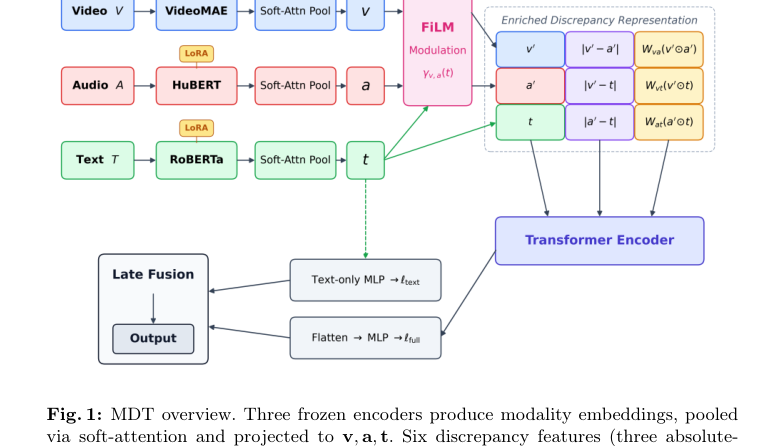
臨床動画における Ambivalence and Hesitancy (A/H、あいまいさと躊躇) の自動認識を目的とした Modality Discrepancy Transformer (MDT) が提案された。従来のマルチモーダル融合手法が抑圧しがちであった「顔・音声・言語チャネル間の矛盾シグナル(クロスモーダル不一致)」を積極的に捉える設計を採用している。3rd ABAW Challenge の BAH データセットにおいて、ラベル付きテストスプリットで Macro F1 0.7408、プライベートリーダーボードで 0.7368 を記録し、単一 GPU で 20 分未満という短時間トレーニングでありながら、既存の最強パブリックベースラインを 10 ポイント以上上回る精度を実証した。
関連研究
A/H の認識においては、 Bekhouche らによるコンフリクト認識型マルチモーダル融合フレームワークが先行している。しかし、標準的な統合手法ではマルチモーダル間の矛盾や不一致を雑音として処理・抑制してしまう課題があった。本研究では、不一致情報を直接表現の構成要素として組み込むことで、この制限を克服している。
新規性と貢献
最大の貢献は、クロスモーダル間の不一致を明示的にモデル化する 9 トークン表現の導入である。単なる特徴の連結や平均化に依存せず、不一致シグナル自体を Transformer の自己注意機構に直接入力する設計により、臨床現場における複雑な情動表現を高精度に識別可能にした点に学術的・実用的な価値がある。
提案手法の詳細
MDT は、 Bekhouche らのフレームワークをベースにしつつ、従来の 6 トークン設計を拡張して 9 トークンの表現を構築している。具体的には、線形射影を通じて学習される 3 つのモダリティ埋め込み、3 つの絶対差分特徴、および 3 つのアダマール積による不一致特徴の合計 9 トークンを使用する。これらは Transformer の自己注意機構によって処理され、FiLM ベースのテキスト条件付き変調や LoRA によるファインチューニングがコアコンポーネントとして組み込まれている。さらに、推論時にはテキスト専用の補助ヘッドと完全なマルチモーダル出力を統合するテキスト誘導型レイトフュージョンブランチが機能する。
評価・考察
BAH データセットの評価において、MDT はラベル付きテストスプリットで Macro F1 0.7408、プライベートリーダーボードで 0.7368 を達成した。これは既存の最強パブリックベースラインに対して 10 ポイント以上の大幅な向上である。特筆すべきは、単一 GPU 環境で 20 分未満のトレーニング時間でこの性能に到達しており、計算コストと精度のトレードオフにおいて極めて高い実用性を示している点である。
応用例と今後の展望
医療・メンタルヘルス分野の臨床面接動画の解析や、カウンセリング支援システムへの応用が期待される。日本の医療・ヘルスケア分野における AI 研究者およびテックリードにとって、マルチモーダルモデルにおける「情報の統合だけでなく不一致の積極的活用」が情動認識精度に与える影響を示す具体的なベンチマークとなり、今後の感情解析アーキテクチャ設計に直接的な示唆を与える。今後は多様な臨床データセットへの汎化性能の検証が課題となる。
結論
Modality Discrepancy Transformer は、マルチモーダル不一致を明示的に捉える 9 トークン表現と効率的なアーキテクチャ設計により、A/H 認識において既存手法を圧倒する性能を示した。計算効率の高さと高精度を両立させたことで、今後の情動認識研究における新たなスタンダードとなる基盤を提供する。
注釈
- Ambivalence and Hesitancy (A/H): 個人が顔、音声、言語の各チャネルを通じて矛盾するシグナルを表現する感情状態(あいまいさと躊躇)。
- LoRA (Low-Rank Adaptation): 大規模モデルのパラメータを効率的に適応させるためのファインチューニング手法。