Text-to-SQLにおけるスキーマリンク不要論──最新LLMを活用しBIRDベンチマークで71.83%を達成
最新の推論能力が高いLLMのコンテキストウィンドウを活用し、スキーマリンクを排除することでBIRDベンチマークにて71.83%の実行精度を達成した手法の提案。
リリース: 2024-08-14 · 読了 5 分論文概要
Karime Maamariらによる本研究は、Text-to-SQLパイプラインにおける従来の必須工程であった「スキーマリンク(関連するテーブルやカラムの抽出・不要なものの排除)」の必要性を再検証したものである。近年の推論能力が高い大規模言語モデル(LLM)は、大量の無関係なスキーマ要素が存在していても必要な要素を適切に活用できるため、モデルのコンテキストウィンドウに収まる規模であればスキーマリンクを完全に排除することが有効であることを実証した。提案手法はBIRDベンチマークにおいて71.83%の実行精度を記録し、ランキング首位を獲得した。
関連研究
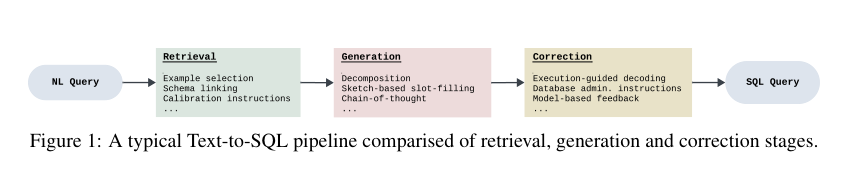
これまでのText-to-SQL手法では、データベースの規模が大きい場合にトークン数削減やノイズ低減を目的としてスキーマリンクによるフィルタリングが必須とされてきた。しかし、不完全なスキーマリンク処理はSQL生成に不可欠なカラムまで除外してしまうという課題を抱えていた。本研究は、近年のLLMのコンテキスト処理能力の向上に着目し、従来の前処理としてのフィルタリングに依存しないアプローチを検証している。
新規性と貢献
本研究の主要な貢献は、Text-to-SQLパイプラインからスキーマリンク工程をあえて省くというパラダイムシフトの提示にある。不要な情報の排除に注力するのではなく、拡張(augmentation)、選択(selection)、修正(correction)といった別のアプローチを組み合わせることで、フィルタリングの漏れによる精度低下を防ぐ設計を採用している。
提案手法の詳細
スキーマがモデルのコンテキストウィンドウ内に収まるケースにおいては、スキーマリンクによる絞り込みを行わず、データベースのスキーマ情報をそのままLLMに入力する。これにより、フィルタリングに起因する情報の脱落を防ぐ。さらに、文脈情報の単純な削減ではなく、クエリ生成精度を高めるための補正・選択メカニズムを採用している。
評価・考察
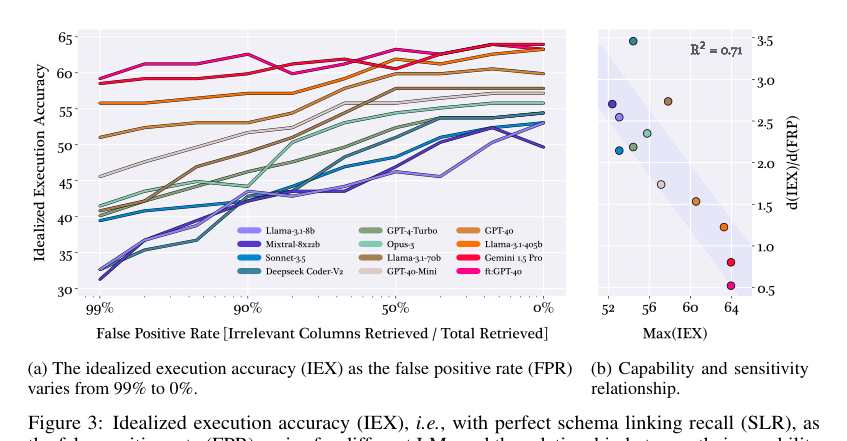
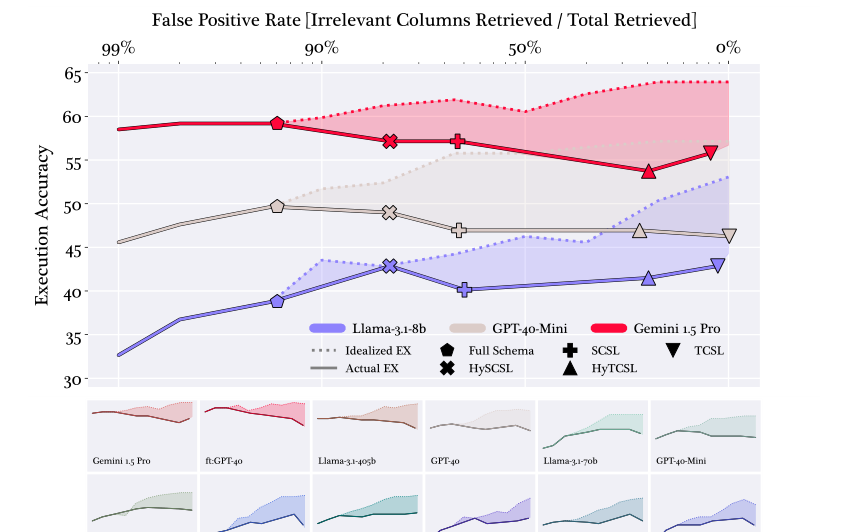
複雑なデータベース構造を持つBIRDベンチマークにおいて、提案手法は71.83%の実行精度(EX)を達成した。実験結果から、近年のモデルは大量の無関係なスキーマ要素が含まれていても適切な要素を自律的に選択・利用できることが確認されており、フィルタリングの有無が生成精度に与える影響が定量的に示されている。
応用例と今後の展望
本手法は、社内データベースに対する自然言語インターフェースやBIツールにおけるデータ分析支援システムへ直接応用できる。日本の金融・流通分野における大規模なリレーショナルデータベースを対象としたテキストからのSQL自動生成において、複雑なスキーマ前処理パイプラインの開発・保守コストを削減できる実務上のインパクトを持つ。今後の課題としては、コンテキストウィンドウの制限を超える超大規模スキーマへのスケーリング手法の確立が挙げられる。
結論
本研究は、近年の優れた推論能力を持つLLMを活用する環境下では、従来のText-to-SQLにおけるスキーマリンクが必ずしも必要ではなく、むしろ排除することが精度向上につながることをBIRDベンチマークの首位獲得によって実証した。
注釈
- Text-to-SQL: 自然言語によるユーザーの質問を、データベースに対するSQLクエリに変換するタスク。
- スキーマリンク: データベース内の多数のテーブルやカラムから、質問の回答に必要な要素を特定・抽出するプロセス。