OCR ノイズ下の LLM キー・バリュー抽出性能を検証する包括的ベンチマーク──クリーンテキスト比で大幅な精度低下を実証
Gemma や LLaMA 3 などのオープンソース LLM を対象に、FUNSD や CORD などのベンチマークで OCR ノイズが構造化抽出に与える影響を系統的に評価した。
リリース: 2026-07-14 · 読了 5 分論文概要
大規模言語モデル(LLM)を用いた文書からの構造化情報抽出が進展する中、現実のOCRノイズ下における挙動は十分に解明されていない。本研究では、オープンソースのインストチューニング済みLLMを対象に、クリーンテキストおよびOCRノイズ環境下でのキー・バリューペア(KVP)抽出に関する系統的なベンチマークを提示する。Gemma、Mistral、Qwen2.5、LLaMA 3、DeepSeekなどのデコーダオンリーモデルを評価し、入力品質、モデル設計、プロンプティングの影響を検証した。
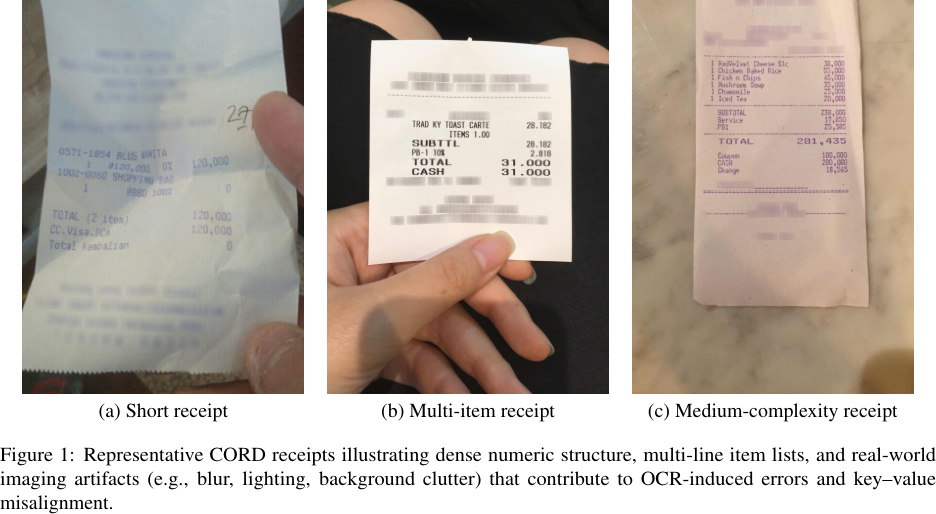
関連研究
従来の情報抽出タスクでは、レイアウト情報を統合した専用のレイアウト認識型システムが主流であった。近年は汎用的なLLMを用いた文書理解が進んでいるが、既存研究の多くは正解テキスト(Gold-text)を前提としており、実運用環境で不可避となるOCRエラーがモデルの推論能力に与える影響を網羅的に比較した評価は不足していた。本研究はこのギャップを埋めるものである。
新規性と貢献
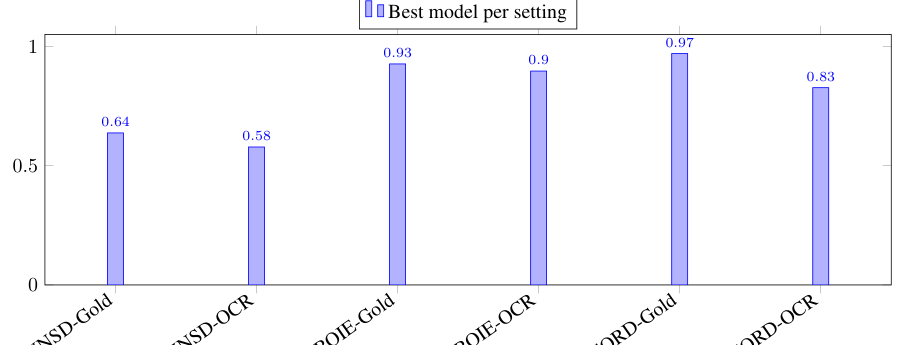
本研究の主要な貢献は、複数の代表的なオープンソースLLMとOCRエンジン(PaddleOCR、EasyOCR、Tesseract)を組み合わせ、FUNSD、CORD、SROIEの各データセットで統一された評価プロトコルを確立した点にある。これにより、クリーンテキストにおける高精度なモデルであっても、OCRノイズが混入した環境では性能が大幅に低下し、モデル間の差異が縮小することを定量的に示した。
提案手法の詳細
評価では、ゼロショット設定の下で各種デコーダオンリーモデルに文書テキストを入力し、キー・バリューペアの抽出精度を測定した。統一された評価プロトコルを用いることで、モデルのセマンティック推論能力と、入力されるテキストの忠実度保持の相関関係を分離して解析できるように設計されている。
評価・考察
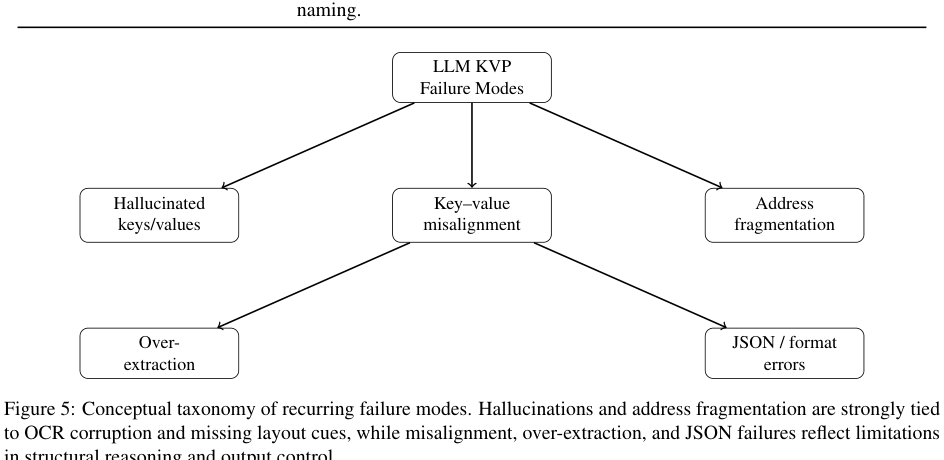
実験結果から、高品質なテキストが利用可能な場合、現代のLLMは強力なセマンティック抽出器として機能し、一部のケースでは教師ありのレイアウト認識型システムに匹敵することが示された。しかし、OCRノイズ下ではパフォーマンスが著しく低下し、入力の汚染が激しくなるにつれてモデル間の性能差が狭まることが判明した。また、キーとバリューの不整合、ハルシネーション、数値の破損といった繰り返し発生する失敗モードが特定された。
応用例と今後の展望
本研究の知見は、OCRシステムとLLMを組み合わせた実務的な文書自動処理パイプラインの構築において重要な示唆を与える。特に、日本の金融・バックオフィス業務における手書き文字や複雑なレイアウトを持つ帳票処理において、LLM単体の性能過信を避け、OCR品質の改善と構造的推論の双方を同時に最適化する必要性を示している。
結論
クリーンテキスト環境と現実のOCRノイズ環境の間には大きな乖離が存在する。本研究は、実運用を見据えたLLMベースの文書情報抽出において、OCR品質の向上とセマンティックモデリングの統合が不可欠であることを強調している。
注釈
- OCR: 光学文字認識(Optical Character Recognition)。画像内の文字をテキストデータに変換する技術。
- KVP(Key-Value Pair):文書から「項目名(キー)」と「その値(バリュー)」のペアを抽出する構造化タスク。