顔面筋電図から発話内容を復元する Myovox ──単語誤り率を既存の 51% から 18.53% へ改善
31チャンネルの顔面 sEMG を用いたオープンボキャブラリー音声デコードにおいて、双方向 Conformer と QLoRA 言語モデルの統合により WER を大幅に低減した。
リリース: 2026-07-15 · 読了 5 分論文概要
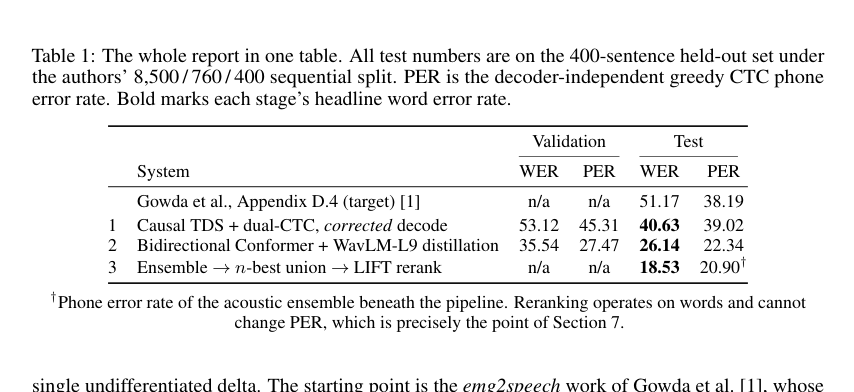
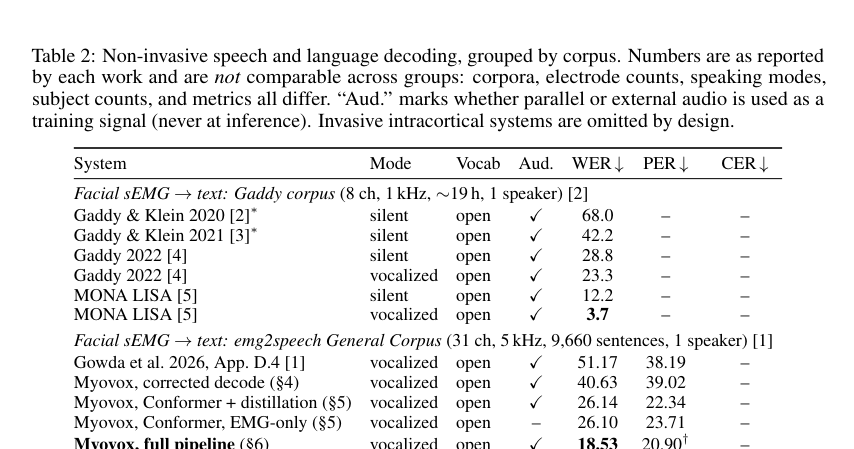
顔面筋肉の表面筋電図(sEMG: surface electromyography)からオープンボキャブラリーの英語テキストをデコードする新手法「Myovox」が提案された。31チャンネルのセンサーを用いて、発話時の顔面筋の活動から音声を読み取る。従来手法である emg2speech General Corpus の公開ベースラインでは単語誤り率(WER)が 51.17% であったが、Myovox ではこれを 18.53% まで引き下げることに成功した。各改良段階は個別に計測されており、音響モデルの再現、双方向 Conformer によるクロスモーダル蒸留、そして 7B 言語モデルによるリランキングの 3 つの要素で構成されている。
関連研究
sEMG を用いた非侵襲的な音声認識(sEMG-to-text)は、声帯を使えない状況でのコミュニケーションやハンズフリーインターフェースの基盤技術として研究が進められている。しかし、従来法ではオープンボキャブラリー環境における認識精度に限界があり、特に単語誤り率の高さが実用化への課題となっていた。本研究は、音声合成や大規模言語モデルの事後処理技術を組み合わせることで、従来の筋電図ベースの音声認識の精度限界に挑んでいる。
新規性と貢献
本研究の主要な貢献は、3段階のモジュール的な改善により、筋電図デコードの WER を劇的に(51.17% から 18.53% へ)改善した点にある。第 1 段階として欠落していたデコード設定を復元してベースラインを確立し、第 2 段階で双方向 Conformer と WavLM-Large を用いたクロスモーダル蒸留を導入、第 3 段階で QLoRA によりファインチューニングされた 7B 言語モデルによるリランキングを適用した。さらに、リランキングの効果が音響的な音素誤り率(約 20.9%)によって頭打ちになるという限界(マイナス結果)を明確に示したことも学術的な貢献である。
提案手法の詳細
Myovox は、名前の由来である myo(筋肉)と vox(声)が示す通り、顔面筋の微小な動きを捉えてテキスト化するパイプラインである。まず、公開されているデータセットの不足していたオープンボキャブラリー設定を再構築し、忠実なベースライン(WER 40.63% / PER 39.02%)を得ている。次に、因果的エンコーダを双方向 Conformer に置き換え、並行して録音された音声の WavLM-Large レイヤー 9 の特徴量を用いた 4 項クロスモーダル蒸留によって学習させることで、筋電図単体からのデコード精度を WER 26.14% / PER 22.34% まで向上させた。最後に、2つの音響モデルをアンサンブルし、マルチスケールの n-best リストを統合した上で、QLO RA によりファインチューニングされた 7B 言語モデルでリランキングを行うことで、最終的な 18.53% の WER を達成している。
評価・考察
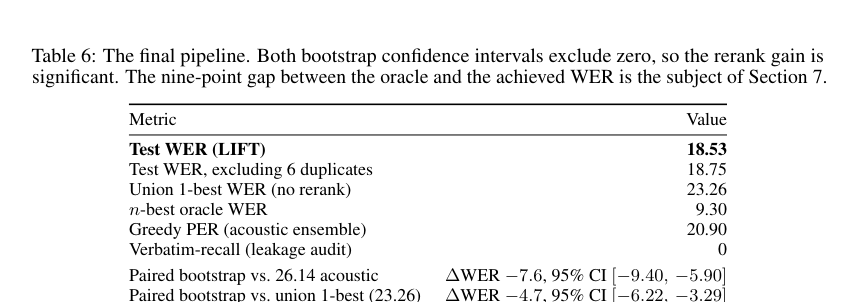
評価は、400文からなるホールドアウトテストセットを用い、著者の公式な 8,500 / 760 / 400 のシーケンシャル分割に基づいて実施された。各ハイパーパラメータはバリデーションで一度だけチューニングされ、テストに適用されている。実験結果から、リランキングによる性能向上のボトルネックは言語モデル側ではなく、音響的な音素誤り率(約 20.9%)にあることが判明した。正解単語自体が音響事後確率に含まれていないため、いかなるリランキング手法を用いても n-best オラクル(9.30%)には到達できないという重要な制約が示されている。
応用例と今後の展望
応用面では、音声を発声できない極限的な環境や、静寂が求められる状況におけるウェアラブル・サイレント音声インターフェースへの応用が考えられる。日本のヒューマンコンピュータインタラクション(HCI)およびアクセシビリティ分野の研究者やデバイス開発者にとって、筋電図と LLM の統合アプローチは、音声入力の代替手段を設計する際の実装指針となる。今後の課題としては、音響的音素誤り率の根本的な削減や、複数話者間でのロバスト性の向上が挙げられる。
結論
Myovox は、顔面筋電図からのオープンボキャブラリー音声デコードにおいて、双方向 Conformer と QLoRA 言語モデルの組み合わせにより WER を 18.53% まで低減させた。リランキングの限界が音素誤り率に起因することを明らかにした点も含め、非侵襲的音声認識の今後の方向性を示す重要な研究である。
注釈
- sEMG (表面筋電図): 皮膚表面の電極を通じて筋肉の電気的活動を計測する手法。
- WER (Word Error Rate): 単語誤り率。機械翻訳や音声認識の精度評価指標。
- PER (Phone Error Rate): 音素誤り率。発話された音素単位での誤り率。
- QLO RA: 量子化技術を併用しながら大規模言語モデルを効率的にファインチューニングする手法。