属性条件付き画像編集で敵対的事例を生成する SemanticAdv ──実世界ブラックボックス API に対する高い攻撃成功率を実証
分離された意味的要因を用いて画像を変化させ、L_p ノルム制限なしで DNN の誤作動を引き起こす SemanticAdv 手法を提案し、Azure Face などの実世界サービスでの有効性を示す。
リリース: 2019-06-19 · 読了 5 分論文概要
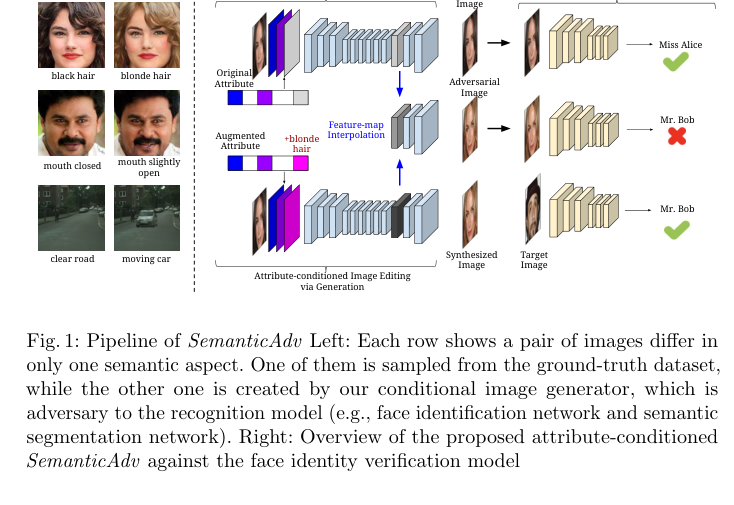
Deep neural networks (DNN) の脆弱性を突く敵対的事例(Adversarial Examples)の生成において、従来主流であった ノルム制限に基づく微小な摂動ではなく、画像の「意味的属性(Semantic Attributes)」の操作による非制限的な敵対的事例生成手法である SemanticAdv が提案された。本研究では、分離された意味的要因(Disentangled Semantic Factors)を活用して制御された意味的変更を加え、顔認証やランドマーク検出などの多様なタスクを誤認させるアルゴリズムを示す。さらに、転移性を利用して Azure face verification service などの実世界のブラックボックス API に対しても高いターゲット攻撃成功率を達成することを実験で証明している。
関連研究
従来の敵対的事例の研究の多くは、元画像からの変更量をピクセル単位の ノルムで微小に抑えることに焦点を当ててきた。しかし、このような手法は人間には検知しにくい一方で、照明の変化や少しの画像変形に対して脆弱であることが指摘されている。本研究は、ピクセル単位の微小なノイズではなく、人間の視覚的にも自然な「意味的属性の変更」に着目し、DNN が高次の意味的特徴をどのように誤認するかを体系的に検証する点において従来研究と一線を画す。
新規性と貢献
本研究の最大の新規性は、 ノルム制限に依存しない「非制限的敵対的事例(Unrestricted Adversarial Examples)」の体系的な生成フレームワークを確立した点にある。顔画像における特定の属性(例えば笑顔や年齢など)を制御可能に変化させることで、モデルのロバスト性を根本から評価する新しい軸を提示した。また、ホワイトボックス環境で生成した意味的摂動が、商用の実世界ブラックボックスサービスに対しても高い転移性を持つことを示した学術的・実用的な貢献は大きい。
提案手法の詳細
提案手法である SemanticAdv は、分離された表現学習を用いて画像の制御可能な意味的要因を抽出する。具体的には、指定された属性条件付き画像編集(Attribute-conditional Image Editing)を行い、特徴マップの補間などを組み合わせることで、モデルを特定の誤認ターゲットへ誘導する摂動を構築する。なぜこの設計を採用したかといえば、単なるピクセルノイズの最適化ではなく、画像全体の意味構造を保ったままモデルの決定境界をまたぐ変化を起こすため、実際の現実空間の変動に近い形で脆弱性を突くことができるからである。
評価・考察
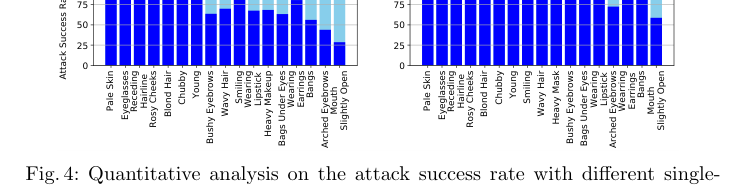
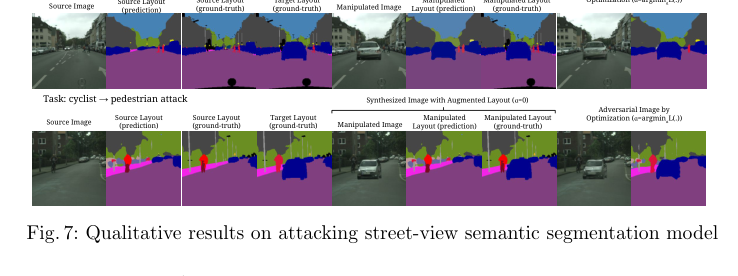
著者らは顔認証やランドマーク検出タスクに加え、街路ビュー画像(Street-view Images)に対するセマンティックセグメンテーションモデルなど、顔認識以外のドメインでも実験を実施している。評価の結果、単一属性の攻撃を用いた場合でも多様な顔認証モデルに対して高い攻撃成功率を記録し、さらに Azure の商用顔認証 API に対する転移攻撃においても実用的な成功率を維持することが確認された。これにより、意味的改変がモデルの転移可能な脆弱性を突く強力な手段であることが定量的に裏付けられている。
応用例と今後の展望
本手法は顔認証システムや自動運転向けの街路ビュー画像認識(例: セマンティックセグメンテーション)など、画像認識 AI を用いる幅広い分野に適用可能である。日本のエンジニアや研究者にとっての実務インパクトとして、生体認証システムや自動運転の画像認識パイプラインを開発・運用する際、単なるピクセル単位のノイズ除去(敵対的訓練など)だけでは、意味的属性の変更を伴う高度な敵対的攻撃を防ぎきれないリスクが示唆されている。今後は、このような意味的変化に対する防御手法(Defensive Approaches)の開発が急務となる。
結論
本論文では、属性条件付き画像編集を用いた新しい敵対的事例生成手法 SemanticAdv を提案した。 ノルムに依存しないアプローチにより、実世界のブラックボックスサービスや多様なビジョンタスクにおいて DNN が持つ構造的な脆弱性を浮き彫りにし、今後のロバストなAIシステム設計に向けた重要な知見を提供している。
注釈
- Adversarial Examples: 機械学習モデルに意図的な誤作動を引き起こすために微小な(あるいは意味的な)改変を加えた入力データ。
- Black-box Service: モデルの内部構造やパラメータが公開されておらず、入出力のみが利用可能な API などのサービス。
- Disentangled Semantic Factors: 画像データに含まれる個別の意味的特徴(ポーズ、照明、表情など)が互いに独立して分離された潜在変数。