LLM 推論ネットワークの最適モデル活性化方針──期待コストを大幅に削減する閾値ベースのルーティング手法
複数 LLM を連携させる推論ネットワークにおいて、モデルの信頼度に基づく閾値制御により性能制約を満たしつつコストを最小化する方針を定式化。
リリース: 2026-07-07 · 読了 5 分論文概要
大規模言語モデル (LLM) の推論コストが高騰する中、複数の異なるコストと性能を持つ expert LLM を組み合わせて効率的にクエリを処理するフレームワーク「inference networks」が提案された。本研究では、指定された性能制約を満たしながら期待推論コストを最小化するモデル活性化問題を定式化し、コスト削減と精度のトレードオフを最適化する。オープンソース LLM を用いた実験により、指定された性能バジェットを維持しつつ大幅なコスト削減が達成できることが示されている。
関連研究
従来、複数の LLM を協調させる手法としてアンサンブルや直列接続(カスケード)を用いたルーティング手法が存在する。しかし、利用可能なモデル群をどのように体系的に配置・制御すべきかについての原則的なアプローチや、コストと性能のトレードオフを厳密に保証する理論的枠組みはこれまで十分に確立されていなかった。本研究は、グラフベースのフレームワークを導入することでこの課題にアプローチしている。
新規性と貢献
本研究の最大の貢献は、LLM の条件付き活性化をグラフ構造(inference networks)としてモデル化し、最適活性化ポリシーが明確な「閾値構造 (threshold structure)」を持つことを証明した点にある。識別タスクおよび生成タスクの双方に対して実用的な信頼度推定機構と閾値計算手法を提供し、経験的なヒューリスティックに依存しない体系的なコスト最適化を可能にした。
提案手法の詳細
本研究では、ノードを LLM、リンクを条件付きモデル活性化とするグラフベースのフレームワーク「inference networks」を導入する。直感的に言えば、すべてのクエリを巨大で高コストなモデルに処理させるのではなく、まずは安価な LLM に処理させ、その出力の信頼度が不十分な場合のみ高コストなモデルへ処理を委譲するという動的な制御を行う。
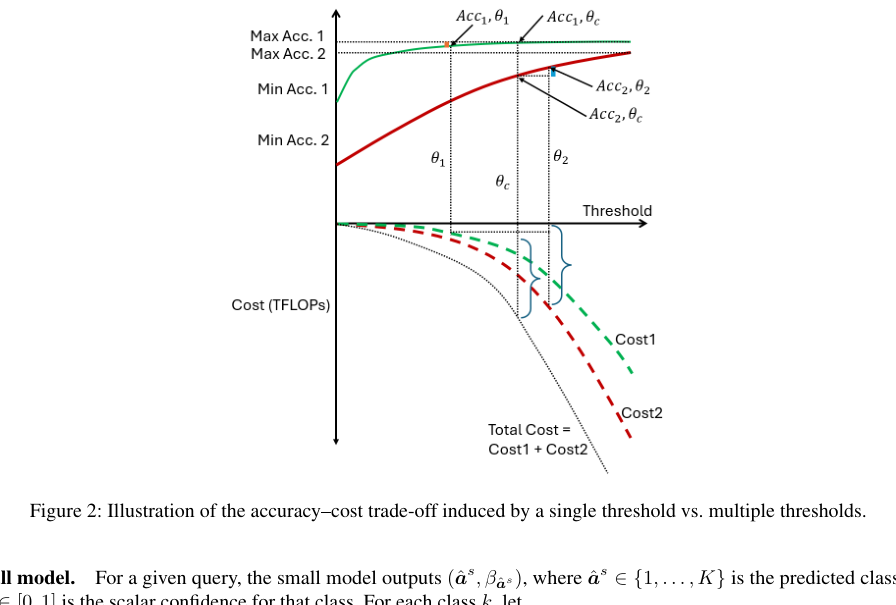
具体的には、最小コストの LLM から順にクエリを投入し、モデルの信頼度が定義された閾値を下回った場合のみ高価な LLM を呼び出す。識別タスクではクラスごとに複数の閾値を設定し、生成タスクでは単一の閾値を用いるポリシーを採用している。
評価・考察
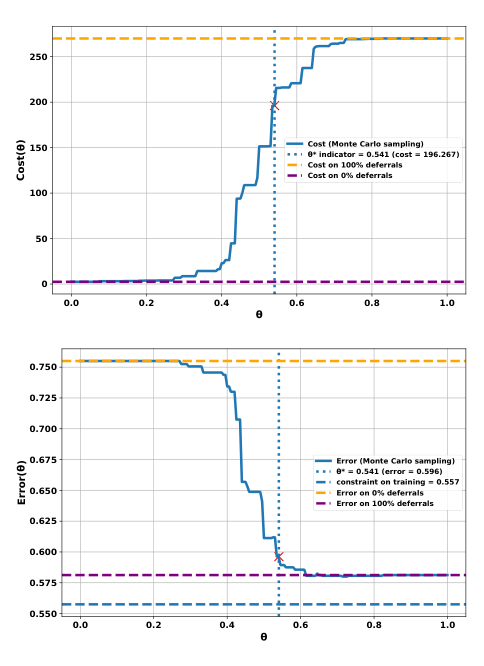
SQuAD などのデータセットおよびオープンソース LLM を用いた実験において、提案する閾値ポリシーが指定された性能予算を厳守しつつ、期待推論コストを劇的に削減できることが確認されている。遅延や誤差の制約に対する感度分析により、閾値パラメータ の調整によってコストと精度のバランスを柔軟に制御できることが示された。
応用例と今後の展望
本手法は、API 経由で多段の LLM を呼び出すエンタープライズ向けの生成 AI アプリケーションやカスタマーサポートシステムにおいて、直接的なインフラコスト削減につながる実務インパクトを持つ。特に数千〜数百万規模のリクエストを処理する国内のコンタクトセンター業務や金融文書解析システムなどの分野において、コスト対効果を最大化するための基盤技術として応用が期待される。
結論
LLM の推論ネットワークにおける最適活性化ポリシーの定式化と閾値構造の証明により、コスト効率の高いモデル運用が可能となった。今後はより複雑なグラフ構造への拡張や動的な環境変動に対する適応力の向上が課題となる。
注釈
- inference networks: 複数の LLM をノード、条件付き活性化をリンクとして表現したグラフベースの推論ルーティングフレームワーク。
- 閾値構造 (threshold structure): モデルの信頼度スコアに基づき、次にどのモデルを呼び出すかを判断するための境界値を基準とした制御方針。