軽微なタイポが LLM の内部プローブを攪乱するメカニズムの解明──不正検知プローブの TPR を 12pp 低下させる弱点を修正する KV キャッシュフォークの提案
プロンプトへの軽微なタイポや句読点落ちが隠れ状態を 43〜56 度回転させてプローブを機能不全に陥れる現象を特定し、KV キャッシュフォークによって検知精度を 95% 回復させた。
リリース: 2026-07-08 · 読了 5 分論文概要
LLM(大規模言語モデル)の隠れ状態(Hidden States)を読み取ることで悪意あるプロンプトを検知するプローブ技術は広く利用されている。しかし、ユーザー入力における軽微なタイポや句読点の抜けといった入力の揺らぎが、隠れ状態の読み取りベクトルを大きく変動させ、検知精度を著しく低下させる現象が確認されている。本研究では、単一メッセージあたり約 3 個の一般的なタイポが含まれるだけで、単一位置型プロンプトインジェクション検知プローブの が 低下することを実証した。この弱点を克服するため、著者らは下流のトークンを活用して迅速な空間的減衰を補う「KV キャッシュフォーク(KV-cache fork)」という新しい手法を提案し、再較正や従来の手法を大きく上回る改善を示している。
関連研究
LLM の安全性担保や脱獄(Jailbreak)検出の文脈において、モデル内部の隠れ状態をプロービングする手法は数多く提案されてきた。しかし、その多くはクリーンな入力テキストを前提としており、敵対的摂動に対する頑健性に関する研究は進んでいたものの、日常的なタイポや軽微な表記ゆれが内部表現に与える影響については十分に検討されていなかった。本研究は、わずかな入力の乱れが内部の表現空間におけるベクトル回転を引き起こす点に着目し、その幾何学的特性を解明している。
新規性と貢献
本研究の主要な貢献は以下の 3 点である。
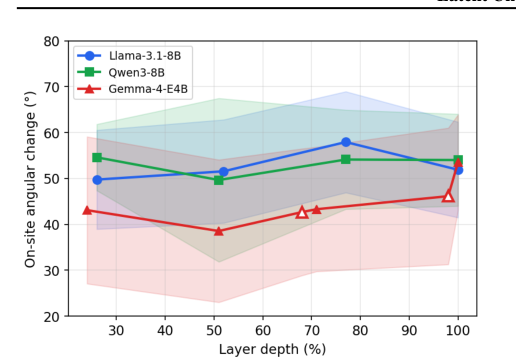
- わずかなタイポが隠れ状態を特定の perturbation トークン位置で 度回転させ、その影響が約 10 下流トークン以内で 以下に減衰するという幾何学的特性を明らかにした点。
- 従来の摂動を考慮したトレーニング(-3.7pp の改善にとどまる)では解決困難だったタイポ起因の検知漏れに対し、再較正のみでは不十分であることを示した点。
- 下流トークンの出力を安全に読み取るための「KV キャッシュフォーク」を導入し、検知精度の低下を 回復(残差 )させた点。
提案手法の詳細
提案手法の核心は、単一位置型プローブが受ける影響の空間的減衰の速さを逆手に取る点にある。ユーザーメッセージの直後に短い固定サフィックスを付与するための「KV キャッシュフォーク」を用いることで、プローブに perturbation(摂動)発生位置から数トークン下流の状態を効率的に読ませる。これにより、タイポによる空間的な回転の影響が急速に減衰する特性を最大限に活かし、局所的な攪乱を安全に回避することが可能になる。複数のモデル(Llama-3.1-8B、Qwen3-8B、Gemma-4-E4B)における検証で、この回転と減衰の幾何学的傾向が普遍的に存在することが確認されている。
評価・考察
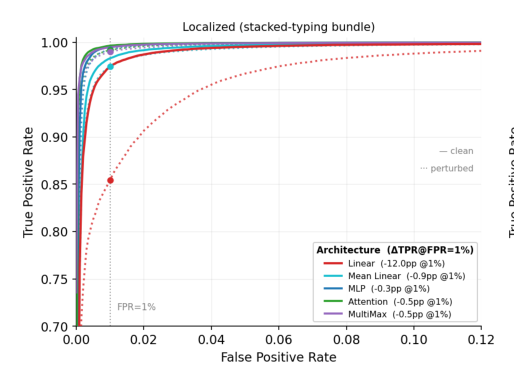
評価実験は Llama-3.1-8B を用いて実施された。単一位置型プローブに 3 つの一般的なタイポが混入した場合、 が 低下することが示された。複数位置のアグリゲーション手法は局所的な摂動(損失 )に対しては有効であるものの、分散型の摂動に対しては不十分であり、アテンションおよびマックスベースのアグリゲーターでも約 の精度低下が残る。これに対し、提案する KV キャッシュフォークは精度低下の を解消し、残差 という優れた数値を達成している。これは摂動拡張トレーニングによる改善()と比較して一桁高い改善効果を示している。
応用例と今後の展望
本研究の成果は、金融サービスやヘルスケア分野におけるセキュアな LLM デプロイメントにおいて極めて高い実務インパクトを持つ。例えば、ユーザーが意図的あるいは誤ってタイポを含めたプロンプトを入力した場合でも、内部プローブ型ガードレールがバイパスされるリスクを大幅に低減できる。国内の AI セキュリティ対策チームや LLM アプリケーション開発企業において、安全性の担保とユーザビリティ(タイポに対する寛容性)を両立させるための標準的なアーキテクチャとして採用される価値がある。今後の課題としては、より大規模なパラメータを持つモデル群や複雑な分散型摂動に対するスケーラビリティの検証が挙げられる。
結論
本研究は、日常的なタイポが LLM の内部隠れ状態におけるベクトル回転を引き起こし、安全性プローブを容易に攪乱することを実証した。その上で、KV キャッシュフォークを用いた新しい読み取り制御手法を提案し、従来の学習ベースの手法を凌駕する精度回復を達成した。内部表現に基づく安全性検証の頑健性を高めるための重要なマイルストーンとなる研究である。
注釈
- KV キャッシュ(KV Cache): Transformer の自己注意機構において、過去のトークンのキー(Key)とバリュー(Value)を保存し、生成時の計算を効率化する仕組み。
- プローブ(Probe): 大規模言語モデルの内部隠れ状態から特定の情報(真偽、感情、悪意の有無など)を線形分類器などで抽出し評価する手法。