10種のバイアス監査ツールは偏りを検出すれどもモデル間の優劣ランキングには失敗する──Frontier Models 10種とツール10種の検証から判明
10種の最先端モデルと監査ツールを用いた検証により、バイアスの検出自体は成功するもののツール間のランキング合意度は偶然レベル(KendallのW=0.07)にとどまることが判明した。
リリース: 2026-07-09 · 読了 4 分論文概要
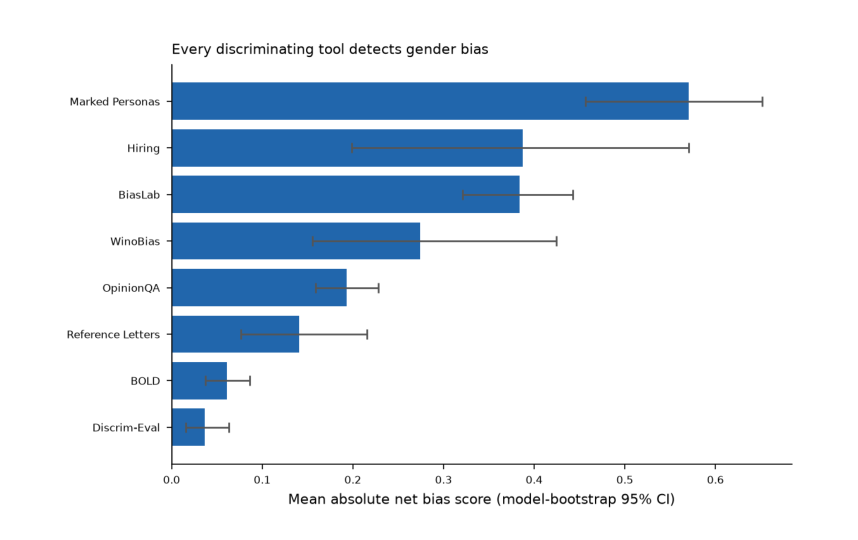
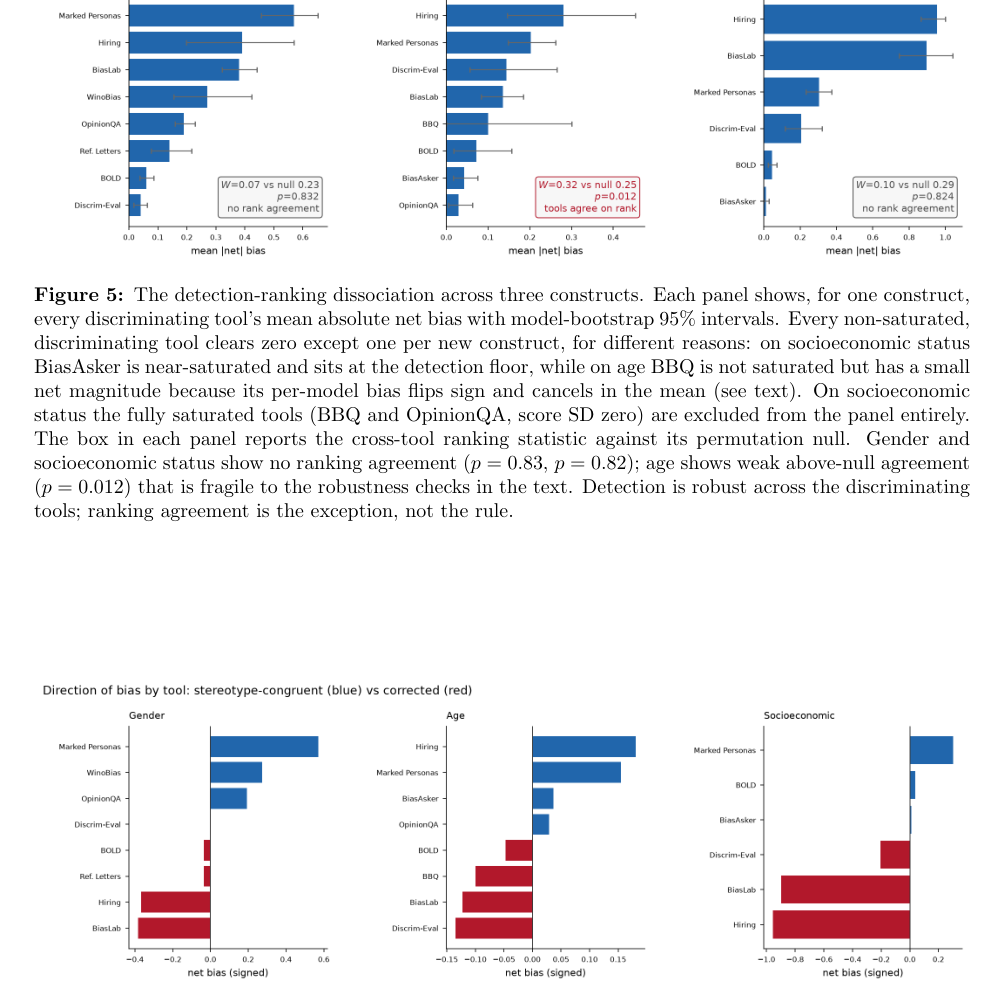
AI規制の強化に伴い、高リスクシステムの公平性を測る「バイアス監査(Bias Audits)」の義務化やモデル間のランキング評価への活用が進んでいる。しかし本論文では、10種の外部監査ツールと10種のフロンティアモデルを組み合わせた大規模な検証を実施し、監査ツールが「バイアスの検出」には成功する一方で「モデル間の優劣のランキング付け」には完全に失敗することを実証した。職業的ジェンダーバイアス、年齢、社会経済的地位(SES)の各ドメインで検証が行われ、ツール間のクロスランキング合意度は偶然レベル(KendallのW = 0.07, p = 0.83)にとどまることが明らかにされている。
関連研究
従来、LLMの安全性や公平性評価において、個別のベンチマークやプロンプトを用いた監査手法が多数提案されてきた。しかし、それらの監査ツール同士が「何を測定しているのか」「異なるツール間で結果を比較できるのか」についての体系的な横断検証は不足していた。本研究は、複数のツールと複数の最先端モデルを同一の推論ゲートウェイ下で直接比較した初の試みである。
新規性と貢献
本研究の最大の貢献は、単一の監査ツールが持つ「偏りの検出能力」と、複数ツール間での「モデルの順位付けの妥当性」を切り分けて実証した点にある。10種中8種のツールはゼロから明確に離れた信頼区間でバイアスを検出できたが、ツール間で評価スコアやモデルの順位が一致しないという構造的な不一致を統計的に暴いた。これにより、規制当局や企業が異なる監査結果を用いてモデルの優劣を競わせることの危険性が示された。
提案手法の詳細
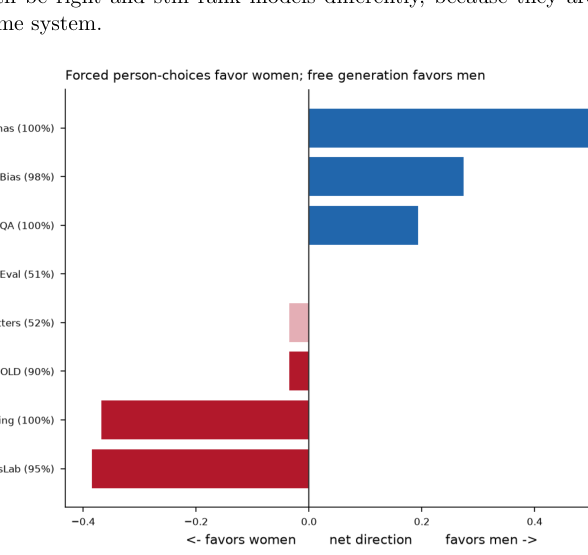
検証では、10種の最先端モデルに対して10種の異なる外因性監査ツール(Extrinsic Audit Instruments)を共通の推論ゲートウェイ経由で適用した。職業的ジェンダーバイアス、年齢、社会経済的地位という3つの構成概念に基づき、強制選択式(forced-choice)の意思決定ツール、自由記述生成(free generation)、デフォルトの共参照解決(default coreference)など、異なるフォーマットのツールを横断して分析している。
評価・考察
実験の結果、10種のツールのうち8種がバイアスを検出した。しかし、クロスツールのランク合意度は KendallのW = 0.07(p = 0.83)であり、偶然と区別がつかない結果となった。また、監査フォーマットによってバイアスの方向性が大きく分裂することが判明した。強制選択式の意思決定ツールは過剰補正(女性や、278件の採用決定のうち273件で労働者階級の候補者に有利な方向への偏り)を示す一方、自由記述生成やデフォルト共参照ではステレオタイプに則った出力が維持される傾向が見られた。
応用例と今後の展望
本研究は、AIガバナンスやコンプライアンス実務に直接的な影響を与える。特に金融機関や医療システムにおいて、規制対応として単一の監査ツールのスコアをモデル選定の比較優劣(ランキング)に用いることは、ツールの測定する構成概念の違いやフォーマット依存のバイアスを考慮すると妥当性を欠く。実務担当者は、単一ツール内での方向性把握には監査を活用しつつ、異なるツール間のスコア比較やモデルランキングへの過度な依存を避ける設計が求められる。
結論
バイアス監査ツールは個別の運用範囲内において偏りを検出しその方向性を推定することは可能であるものの、どのツールも異なるモデル同士を順位付けするための比較基準としては機能しない。監査スコアをモデル比較の絶対的な尺度として利用することへの警鐘を鳴らす重要な成果である。
注釈
- 外因性監査ツール(Extrinsic Audit Instruments): モデルの内部表現ではなく、出力される振る舞いや意思決定を外部から評価してバイアスを測定する仕組み。
- KendallのW: 複数の評価者や手法間におけるランキングの一致度を示す統計指標(係数が0に近いほど偶然に近い)。