単一の表データからの事前学習で汎化を獲得する Tabular Foundation Model
大規模な事前学習データを不要とし、単一のリアルデータセットを用いた自己教師あり学習により、多様なベンチマークで強力な転移性能を達成したことを実証した。
リリース: 2025-11-12 · 読了 5 分論文概要
近年の Tabular Foundation Model (TFM) において、広範な汎化性能を獲得するには大規模な合成コーパスや大量の実データによる事前学習が不可欠とされてきた。本論文では、そのような通説に反し、わずか 1 つのリアルな表データを用いたシンプルな自己教師あり事前学習であっても、異質なベンチマーク間で強力な転移性能が発揮されることを実証している。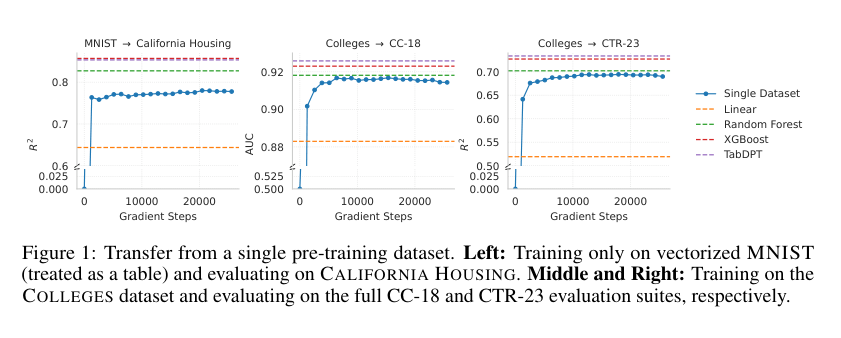
関連研究
これまでの TFM 開発や in-context learning の研究では、TabPFN の事前分布や TabDPT のような巨大なトレーニングデータセットのコレクションが必須であると考えられてきた。本研究は、事前学習データの規模そのものよりも、データから構築可能なタスクの数や品質が重要である点に着目し、従来手法の前提に疑問を投げかけている。
新規性と貢献
本研究の最大の貢献は、大規模な事前学習用データセットコレクションを用意せずとも、単一の表データから構築した自己教師あり学習によって強力な TFM の汎化性能が引き出せることを示した点にある。多数の多様なデータセットで体系的な事前学習と評価を行い、どのようなデータ特性がドメインを跨ぐ汎化に寄与するのかを解明した。
提案手法の詳細
提案手法の核となるのは、単一の表データからいかに多くの多様なタスクを生成するかという点である。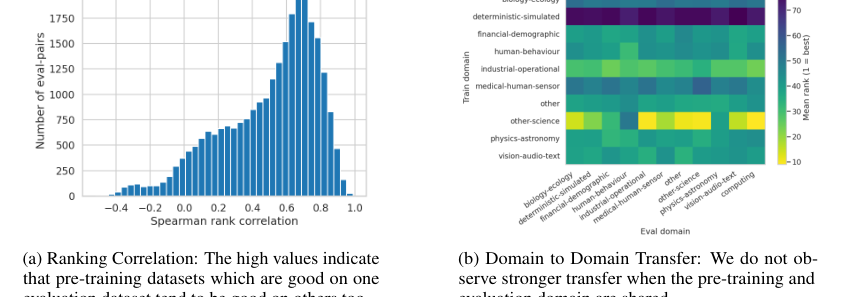 多くの TFM が共通して持つ事前学習手順に対し、データセットから抽出できるタスクの数と質が下流タスクの性能を左右する主因であることを示し、その設計の妥当性を直感的に裏付けている。
評価・考察
多様なデータセットを用いた体系的な検証により、特徴量やインスタンスの重要度比較、さらにユニークタスク数と下流タスクの AUC の関係性が分析された。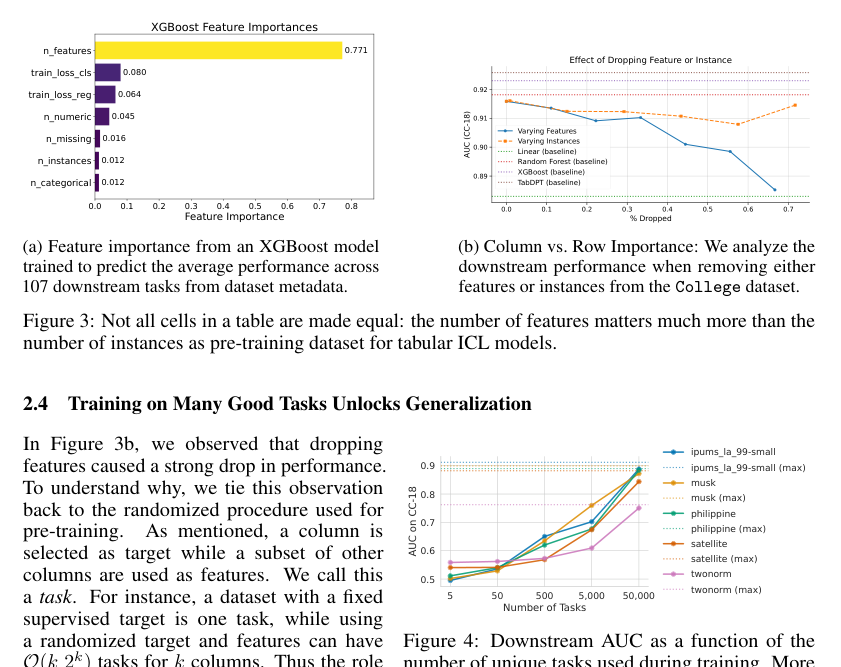 この結果から、単一の表データであっても十分なタスク数が担保されていれば、ドメイン間転移において既存の複雑な事前学習手法に匹敵する性能を維持できることが確認されている。
応用例と今後の展望
金融データや医療データといった、大規模な外部データを集めることが困難でプライバシー上の制約が厳しい業界において、社内の単一の代表的な表データから高精度な予測モデルの土台を構築するアプローチへの応用が考えられる。日本の金融業や医療分野などのデータ分析基盤において、学習データの収集コストを劇的に削減できる実務インパクトが期待される。今後はより多様なデータ構造に対するタスク生成メカニズムの拡張が課題となる。
結論
TFM の汎化性能は、必ずしも大規模な事前学習コーパスの規模に依存するものではなく、単一の表データから構築されるタスクの数と質によって実現可能であることが示された。本知見は今後のデータ効率的な基盤モデル設計に新たな指針を与える。
注釈
- Tabular Foundation Model (TFM): 表形式データ(スプレッドシートや関係データベースのテーブル)の処理を目的とした基盤モデル。