LLMルーティングによるText-to-SQL最適化手法──BIRDベンチマークでコスト削減と高精度を両立
Text-to-SQLにおけるクエリ難易度に応じた動的LLMルーティングにより、最高性能モデルと同等の精度を維持しつつ推論コストを削減する手法を提案。
リリース: 2024-11-06 · 読了 5 分論文概要
Text-to-SQLの分野において、高精度な大規模言語モデル(LLM)は複雑なクエリに対して優れた性能を発揮する一方で、単純なクエリに対しても過剰なレイテンシと金銭的コストを発生させる課題があった。本論文では、各クエリに対して正確なSQLを生成できる最もコスト効率の高いLLMを動的に選択する、初のLLMルーティングアプローチを提案する。スコアベースと分類ベースの2種類のルーティング戦略を設計し、BIRDデータセットを用いた実験において、コストを削減しつつ最高性能モデルと同等の精度を達成することを示した。
関連研究
これまでのText-to-SQL研究の多くは、単一の強力なLLMのプロンプトエンジニアリングやファインチューニング、あるいは固定のアンサンブル手法に依存していた。動的なモデル選択に関する研究は汎用タスクでは存在していたが、Text-to-SQL特有のスキーマ理解や構文の正確性を考慮したルーティング手法の適用は本研究が初めてとなる。
新規性と貢献
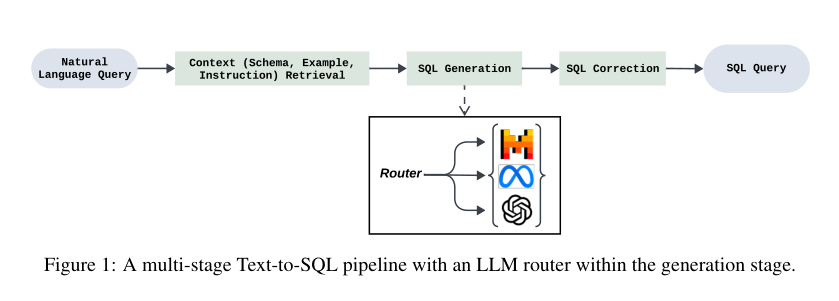
本研究の主要な貢献は、Text-to-SQLパイプラインに特化した動的LLMルーティングの枠組みを初めて確立した点にある。クエリの難易度や特性に応じて、軽量なモデル(例: gpt-4o-miniやLlama)と高性能モデル(例: gpt-4o)を動的に切り替えることで、実運用におけるコストと精度のトレードオフを最適化する仕組みを提供している。
提案手法の詳細
提案手法では、効率的なトレーニングと推論を念頭に設計された2つのルーティング戦略(スコアベースおよび分類ベース)を採用している。クエリの構造的特徴や複雑さを評価し、必要十分な能力を持つ最小限のコストのLLMへタスクを割り振る設計となっている。これにより、単純なSQL生成には安価なモデルを割り当て、複雑なJOINや集約関数を含むクエリには高性能モデルを確実にルーティングする直感的な仕組みを実現している。
評価・考察
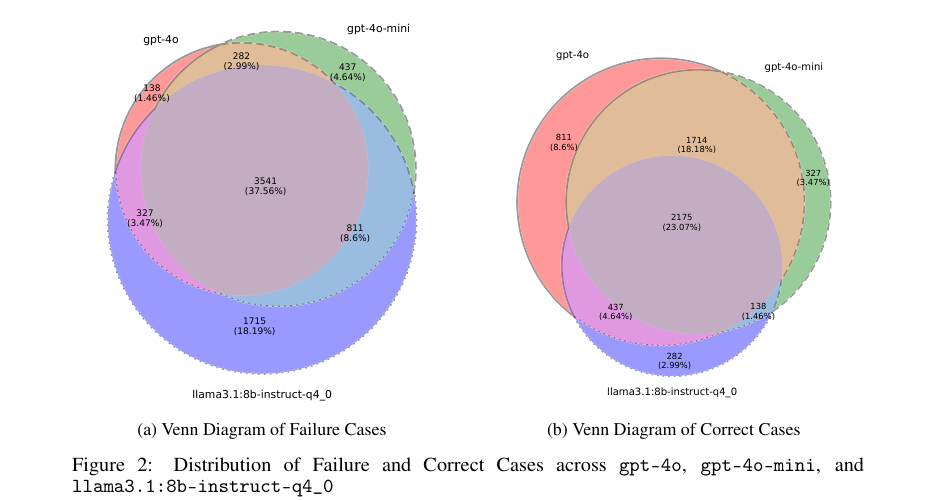
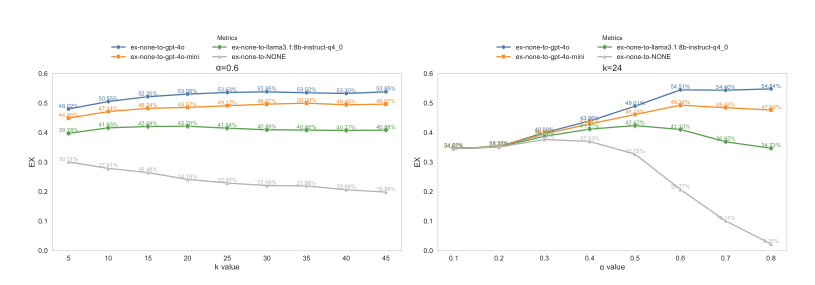
BIRDデータセットを用いた実験により、提案するルーターがコスト削減と精度のバランスを取る有効性を示している。スコアベースルーターにおいては、異なるルーティング戦略の変更が実行精度に与える影響を検証し、実用的な精度を維持できることを確認した。
応用例と今後の展望
本手法の実務インパクトとして、数百万件規模のクエリを処理するデータ基盤やBIツールを運用するSaaS企業において、LLMのAPIコストを大幅に削減できる可能性がある。特に、定常的なテキストベースのデータ抽出機能を持つ金融・EC領域のシステム開発において有効である。今後の課題としては、より多様なSQL方言への対応や、ルーティング自体のオーバーヘッドのさらなる軽減が挙げられる。
結論
本論文では、Text-to-SQLタスクにおけるLLMルーティングの有効性を実証した。クエリごとの難易度に応じた動的なモデル選択により、コストを抑制しつつ高精度なSQL生成を維持できる新しい道筋を示した。
注釈
- Text-to-SQL: 自然言語の入力をデータベースのクエリ言語であるSQLに変換する技術。
- BIRD: データベースのスキーマと複雑な外部知識を必要とする大規模なText-to-SQLベンチマーク。