総パラメータ数 122B の MoE モデル T1 を強化学習で訓練、Terminal-Bench 2.1 で 64.0% の解決率を達成
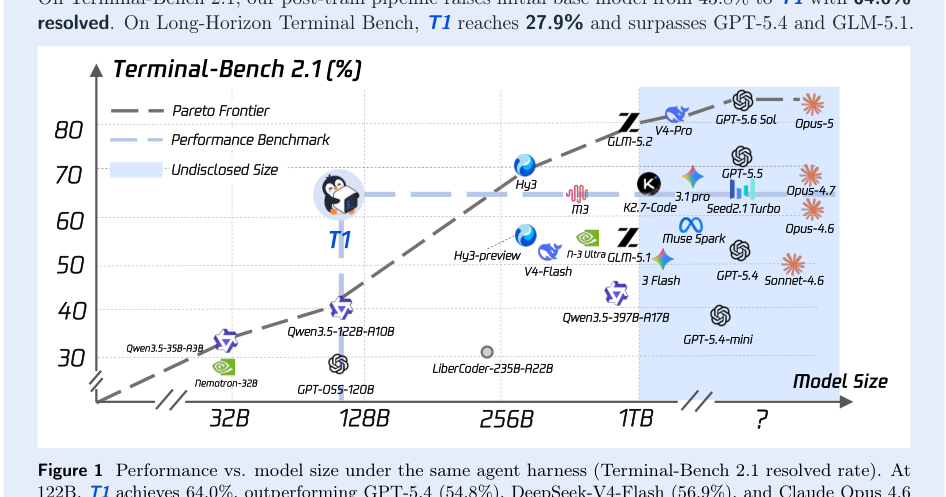
クラウドサンドボックス上のリアルシェルで 300 ターン以上の長文脈タスクをこなす T1 モデルを提案し、Terminal-Bench 2.1 で 64.0% を記録。
リリース: 2026-09-10 · 読了 5 分論文概要
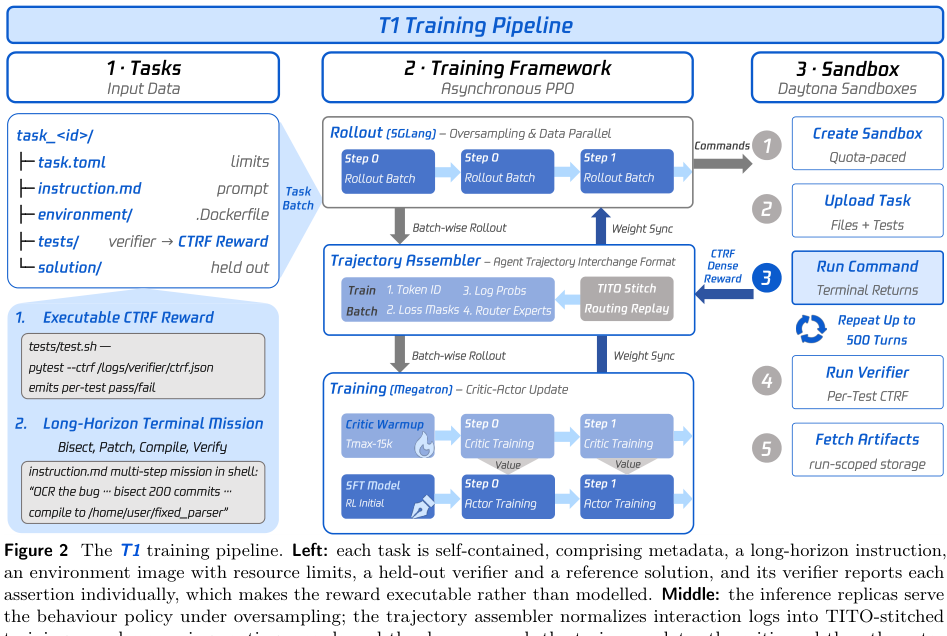
AI エージェントの利用がコーディングや科学的発見といった長期タスクへシフトする中、ターミナル環境での動作に特化した強化学習ベースのモデル「T1」が提案された。総パラメータ数 122B の MoE(Mixture-of-Experts)構造を採用し、クラウドサンドボックス上のリアルシェルにおいて 1 タスクあたり 300 ターン以上のツールコールを実行する。各タスク固有のベリファイア(検証器)による報酬設計と、TITO(Training on the Exact Sampled Token Identifiers)およびロールアウト・ルーティング・リプレイ(R3)と呼ばれる安定化手法により、Terminal-Bench 2.1 において初期ベースモデルの 43.8% から 64.0% へ解決率を大幅に引き上げた。
関連研究
従来のエージェント向けモデルは、短い対話や限定的なツール利用を前提としたものが多く、300 ターンを超えるような長期的なコンテキスト管理や、シェル環境の動的な状態変化を伴う複雑なタスクでは性能が低下する課題があった。本研究は、強化学習を用いたアクター・クリティック訓練における不安定性を克服し、大規模な MoE モデルで長文脈ターミナルタスクを安定して遂行できる点を既存研究と差別化している。
新規性と貢献
本研究の主要な貢献は、アクト・クリティック訓練の安定化レシピと、完全に出水分布外(OOD)の訓練用コーパスを組み合わせた点にある。具体的には、訓練・推論間のログ確率差を 0.021 から 0.013 に低減し、損失領域におけるトークン・ドリフトを完全に排除することに成功した。また、Terminal-Bench 2.1 における解決率を 64.0% に向上させ、Long-Horizon Terminal Bench では 27.9% を記録して一部のフロンティアモデルを上回る性能を示した。
提案手法の詳細
T1 の学習レシピは主に以下の要素で構成されている。第 1 に、アクター・クリティック訓練を安定させるための積極的なウォームスタートと、通過したベリファイアの絶対数に基づいて軌跡を評価する高密度なプロセス報酬の導入である。第 2 に、TITO 構築による安定した最適化(正確なサンプリング済みトークン識別子での訓練とターン境界でのドリフト修復)と、ロールアウト・ルーティング・リプレイ(R3: 各 MoE 層でのサンプラーのトークン毎のエキスパート選択を記録し訓練時にリプレイする仕組み)の採用である。第 3 に、Terminal-Bench 2.1 から完全に分離された独立シードおよび合成タスクによる完全な OOD 訓練コーパスの利用であり、ベンチマークへの過剰適合を防いで汎用的な機能移転を実現している。
評価・考察
評価実験では、Terminal-Bench 2.1 および Long-Horizon Terminal Bench が使用された。Terminal-Bench 2.1 において、T1 はベースモデルの 43.8% から 64.0% へ解決率を向上させた。また、Long-Horizon Terminal Bench では 27.9% を達成し、GPT-5.4 や GLM-5.1 を上回るスコアを記録した。TITO と R3 の組み合わせにより、訓練・推論間の乖離が効果的に抑えられていることが実証されている。

応用例と今後の展望
本手法は、クラウド上の複雑なインフラ運用自動化や大規模なソフトウェア開発支援など、長時間のシェル操作が必要とされる開発・運用現場への応用が期待される。日本のソフトウェア開発やインフラ管理の分野において、数千ステップに及ぶデバッグやCI/CDパイプラインの自動修復といった実務タスクに対し、エージェントの信頼性を高める基盤技術としてのインパクトを持つ。今後の課題は、さらなる長文脈化と、未知のシステム環境におけるロバスト性の向上である。
結論
T1 は、122B パラメータの MoE モデルに対して強化学習と厳格な訓練安定化レシピを適用することで、長文脈ターミナルタスクにおいて優れた性能を発揮することを示した。TITO や R3 といった手法により訓練時のドリフトを抑え、実用的なエージェント構築に向けた新たな道筋を提示している。
注釈
- MoE (Mixture-of-Experts): 入力ごとに異なる少数のサブネットワーク(専門家)を選択して処理を行うことで、モデルの総パラメータ数を増やしつつ計算コストを抑えるアーキテクチャ。
- TITO (Training on the Exact Sampled Token Identifiers): サンプリングされた正確なトークン識別子を用いて学習を行うことで、訓練と推論の乖離を防ぐ手法。