LLM の自己改善を最適化する Negative Self-Distillation 手法──誤った推論の回避により推論性能を向上
正解の模倣を強制する従来の自己蒸留が持つ探索的行動の抑制を解消し、動的ゲーティング機構により基礎的な言語能力を保持しつつ推論性能を改善する新フレームワーク。
リリース: 2026-09-10 · 読了 5 分論文概要
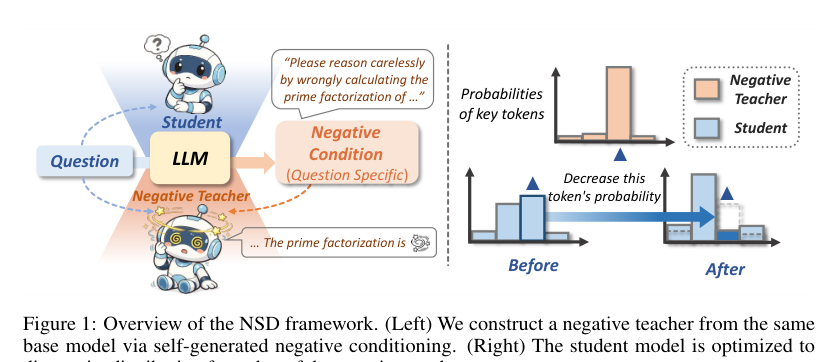
Large Language Model (LLM) の自己改善において主流である On-Policy Self-Distillation (OPSD) は、正解などの特権情報に条件付けられた過度に自信を持った推論トレースの模倣を学生モデルに強制するため、不確実性の表現を抑制し、困難な問題の解決に必要な探索的・自己修正的行動を損なうという問題があった。本論文では、模倣ではなく誤った推論からの逸脱(Divergence)によって LLM を最適化する新フレームワーク Negative Self-Distillation (NSD) を提案する。
関連研究
従来、LLM の自己改善や自己蒸留の分野では OPSD に代表されるように、正解データを用いたアプローチが広く研究されてきた。しかしこれらは、人為的またはモデル自身の過剰な自信に基づく推論経路への強制的な適応を引き起こし、結果として複雑な推論タスクでの性能劣化を招いていた。本研究は、正解の模倣ではなく「不適切な推論の回避」に焦点を当てる点で従来のアプローチと一線を画す。
新規性と貢献
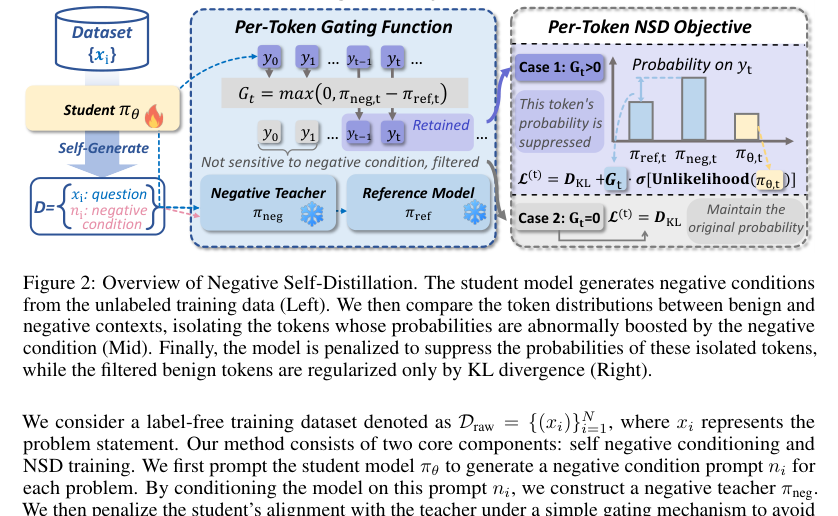
NSD の主な貢献は、外部の監督信号や正解データに依存せず、モデル自身に質問固有のネガティブな条件(例: 「不注意な推論者」としての振る舞い)を生成させ、その自己生成されたネガティブ教師から出力分布を離すことで学習を行う点にある。さらに、素朴なアンラーニング手法の適用で懸念される言語的トークンとの混同を、動的ゲーティング機構によって解決している点も学術的・実用的に大きな貢献である。
提案手法の詳細
NSD では、単に全てのトークンに対して罰則を課すのではなく、動的ゲーティング機構(Dynamic Gating Mechanism)を導入している。これにより、推論にクリティカルなトークンを自動的に識別・隔離し、モデルの基礎的な言語事前知識を破壊することなく、勾配更新を行動の欠陥のみに限定することが可能となっている。
評価・考察
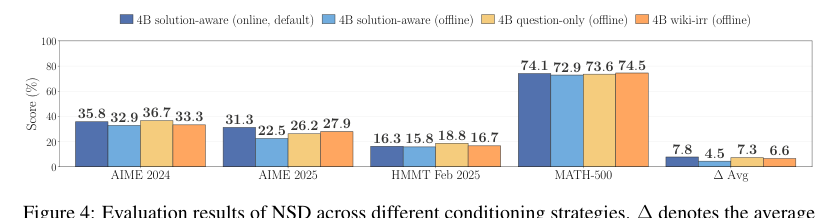
実験結果において、NSD は OPSD およびその他のラベルなし自己ブートストラップ強化学習(RL)ベースラインを一貫して上回る性能を示した。不適切な推論を避けるというアプローチが、複雑な推論タスクにおけるロバストな問題解決能力の向上に寄与することが実証されている。
応用例と今後の展望
本手法は、複雑な論理推論や数学的証明を扱う高度な LLM の強化学習パイプラインに直接応用できる。例えば、金融や医療分野における高度な推論システムの開発において、モデルの誤った思考プロセスの自己修正能力を安全に高める実務インパクトが見込まれる。今後の課題としては、より多様なタスクドメインや大規模モデル群へのスケーラビリティの検証が挙げられる。
結論
本研究は、LLM の自己改善において正解の模倣から脱却し、自己生成された誤った推論からの逸脱を促す Negative Self-Distillation (NSD) を提案した。動的ゲーティング機構を組み合わせることで、基礎的な言語能力を保持しながら推論性能を大幅に改善できることを示した。
注釈
- On-Policy Self-Distillation (OPSD): LLM が自身を教師として学習する自己蒸留手法のうち、オンラインで生成されたサンプルを用いるパラダイム。
- 動的ゲーティング機構: モデルの出力において、推論に不可欠なトークンと一般的な言語トークンを動的に識別し、制御するためのメカニズム。